一,jvm类加载机制
1.1 什么是类加载机制
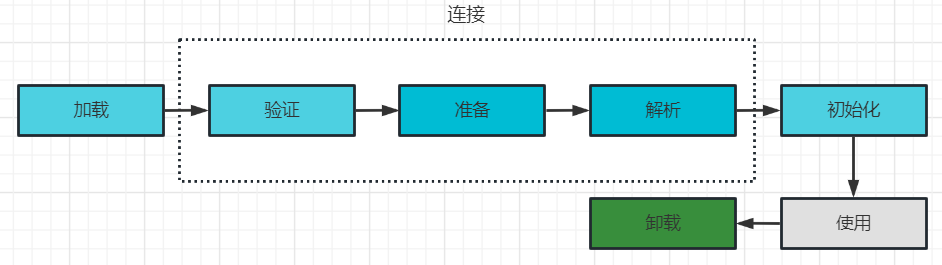
java代码编译后就会生成JVM能够识别的二进制字节流文件*.class文件,将class文件加载到内存,最终成为可以被JVM直接使用的Java类型,这个过程叫做JVM的类加载机制。
1.2 类加载过程
class文件中的“类”从加载到JVM内存中,到卸载出内存过程有七个生命周期阶段:
2026/9/27大约 18 分钟
java代码编译后就会生成JVM能够识别的二进制字节流文件*.class文件,将class文件加载到内存,最终成为可以被JVM直接使用的Java类型,这个过程叫做JVM的类加载机制。
class文件中的“类”从加载到JVM内存中,到卸载出内存过程有七个生命周期阶段:
调用线程池的shutdown()或shutdownNow()方法,线程当前状态如何处理
| 线程当前状态 | shutdown() | shutdownNow() |
|---|---|---|
| 正在执行任务 | 继续执行,完成后退出 | 中断线程,但任务可能继续执行,取决于是否响应中断,不是"完成后退出",而是任务执行完后检测到 STOP 状态退出,如果任务不响应中断,会一直执行到完成(可能无限循环) |
| 等待获取任务 | 中断空闲线程, 线程在 workQueue.take() 处被中断,抛出InterruptedException异常,线程池自己捕捉到这个异常,继续自旋判断如果队列为空,rerurn null后,线程自然结束。 | 中断所有线程, 线程在 workQueue.take() 处被中断,抛出InterruptedException异常,线程池自己捕捉到这个异常,继续自旋判断发现是STOP,不管任务队列是否为空直接rerurn null后,线程自然结束。 |
| 刚获取任务 | 正常执行该任务 | 中断线程,任务可能执行也可能不执行,任务可能继续执行,取决于是否响应中断,不是"完成后退出",而是任务执行完后检测到 STOP 状态退出,如果任务不响应中断,会一直执行到完成(可能无限循环) |
| 新提交任务 | 拒绝(抛出异常) | 拒绝(抛出异常) |
| 线程池状态 | SHUTDOWN | STOP |
while(true){
    // 1,预期值X
    // 2,要修改的新值Y
    if(CompareAndSet(X,Y)){
        break;
    }
} Java内存模型(Java Memory Model简称JMM)是一种抽象的概念,并不真实存在,它描述的是一组规则或规范,通过这组规范定义了程序中各个变量(包括实例字段,静态字段和构成数组对象的元素)的访问方式。每个JVM 的实现都要遵守JMM规范,JMM规范的保障了并发程序运行在不同的虚拟机上时,得到的程序结果是安全可靠的。如果没有JMM内存模型来规范,就可能会出现,经过不同 JVM 翻译之后,运行的结果不相同也不正确的情况。
java运行时内存模型JVM运行程序的实体是线程,在每个线程创建时,JVM都会为其创建一个工作内存(有些地方称为栈空间),用于存储线程私有的数据。Java 内存模型JMM规定所有变量都存储在主内存,主内存是共享内存区域,所有线程都可以访问,但线程对变量的操作(读取赋值等)必须在工作内存中进行。工作内存是线程私有,所以不同的线程间无法访问对方的工作内存,线程间的通信(传值)必须通过主内存来完成。
1,事务就是由单独单元的一个或多个sql语句组成,在这个单元中,每个sql语句都是相互依赖的。而整个单独单元是作为一个不可分割的整体存在,如果单元中某条sql语句一旦执行失败或者产生错误,那么整个单元将会回滚。所有受到影响的数据将返回到事务开始之前的状态,但是如果单元中的所有sql语句都执行成功的话,那么该事务也就被顺利执行。
2,往通俗的讲就是,事务就是一个不可分割整体,里面的内容要么都执行成功,要么都不成功。不可能存在部分执行成功而部分执行不成功的情况。
3,数据都是通过各种不同技术的存储引擎来引导存储的,不同的存储引擎,都有各自的特点。在mysql中,常见的存储引擎有innodb、myisam,memory等。其中innodb支持事务(transaction),而myisam,memory等不支持事务。
索引其实是一种数据结构,能够帮助我们快速的检索数据库中的数据.
按数据结构分类:BTree索引,Hash索引,full-index全文索引.
| InnoDB | MyISAM | Memory | |
|---|---|---|---|
| B+tree索引 | √ | √ | √ |
| Hash索引 | √ | √ | × |
| Full-text索引 | √(MySQL5.6.4) | √ | × |
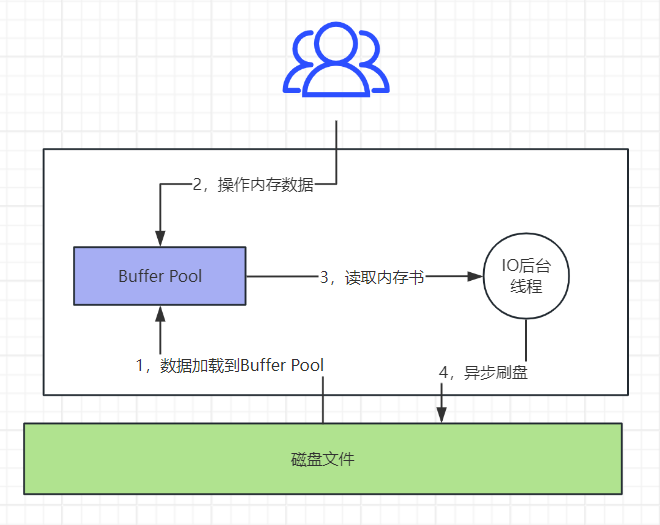
Buffer Pool是MYSQL数据库中的一个重要的内存组件,介于外部系统和存储引擎之间的一个缓存区,针数据库的增删改查这些操作都是针对这个内存数据结构中的缓存数据执行的,在操作数据之前,都会将数据从磁盘加载到Buffer Pool中,操作完成之后异步刷盘、写undo log、binlog、redolog等一些列操作,避免每次访问都进行磁盘IO影响性能。
解析切面,创建代理
	// 1,关闭mysql的自动提交事务
try{
	// 原方法
}catch (Throwable var20) {
	// 2,事务回滚
} finally {
	// 清空
}
// 3,事务提交第一步:导入jar
<dependency>
    <groupId>org.springframework.retry</groupId>
    <artifactId>spring-retry</artifactId>
</dependency>
<dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-aop</artifactId>
</dependency>假设两个人A、B两个情报员,需要通过书信交流情报。AB双方想要真正交流情报,首先需要建立交流渠道、需要确保自己能发(SYN)且别人能收(ACK):
二次握手:
A:“你能收到我写的信吗?”(A:SYN)
B:“我能收到你写的信!你能收到我写的信吗?”(B:ACK-B:SYN)
三次握手:
A:“你能收到我写的信吗?”(A:SYN)
B:“我能收到你写的信!你能收到我写的信吗?”(B:ACK-B:SYN)
A:“我也能收到!”(A:ACK)
四次握手:
A:“你能收到我写的信吗?”(A:SYN)
B:“我能收到你写的信!”(B:ACK)
B:“你能收到我写的信吗?”(B:SYN)
A:“我也能收到!”(A:ACK)
好的,我们现在解释一下常见的问题。
问题1:为什么TCP二次握手不可以?
根据二次握手中A和B的交流、可以发现A可以确定自己能发(SYN)、B能收(ACK),但是B只能确定自己能发(SYN),A能不能收(ACK)到这就不确定了。试想一下你和你朋友写信,一直没收到朋友的回信,你还会继续写下去吗,你会怀疑自己是不是发的地址不对,或者朋友没有收到信,再说写下去也是白写,平白浪费时间。
问题2:为什么不是四次握手?
根据四次握手中A和B的交流、可以发现A可以确定自己能发(SYN)、B能收(ACK),B也能确定自己能发(SYN),A能收(ACK)到。那为什么不采用四次握手?因为B家没钱,为了节省钱,就写了一封信做了两件事,回答朋友的问题并问出自己的问题。